Keszi Roland
Mesterséges intelligencia és adattudomány
Mesterséges intelligencia szakértő (Pannon Egyetem - Mérnöki Kar), szociológus PhD (Eötvös Loránd Tudományegyetem) és MBA (Budapesti Corvinus Egyetem - Corvinus Business School).
Prediktív modelleket építek és értékelek a klasszikus regressziótól a nagy nyelvi modellekig, és egy eredmény érthető magyarázatát ugyanolyan fontosnak tartom, mint magát az eredményt.
Az alábbi projektek mindegyike bemutatja a kérdést, az adatokat, a módszert és a következtetéseket; a teljes kód a GitHub oldalamon érhető el.
Projektek
A részletes esettanulmányok angol nyelvűek; a workshop-beszámoló magyarul is olvasható.
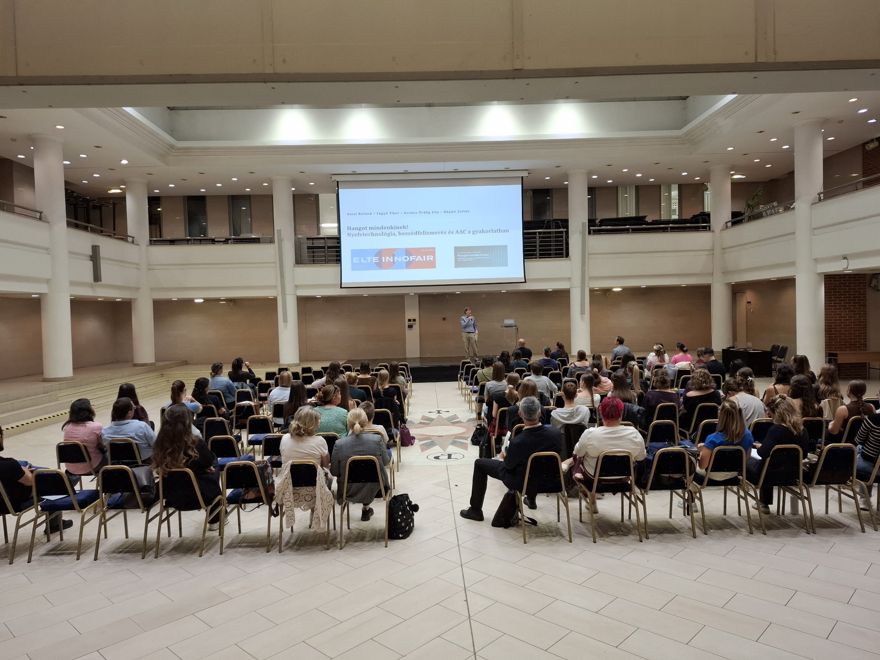
Hangot mindenkinek! Workshop a nyelvtechnológiáról, a beszédfelismerésről és az AAC-ről
Az ELTE Innofair 2026-on általam kezdeményezett, szervezett és moderált workshop. Nyitóelőadásom a beszédfogyatékosság epidemiológiai becsléseit és a nyelvtechnológiai kutatások tudománymetriai áttekintését kapcsolta össze. Ezt a beszédfelismerésről, a robot kérdezőbiztosról szóló előadások és a Talkie AAC-alkalmazás élő bemutatója követte. 129-en regisztráltak.
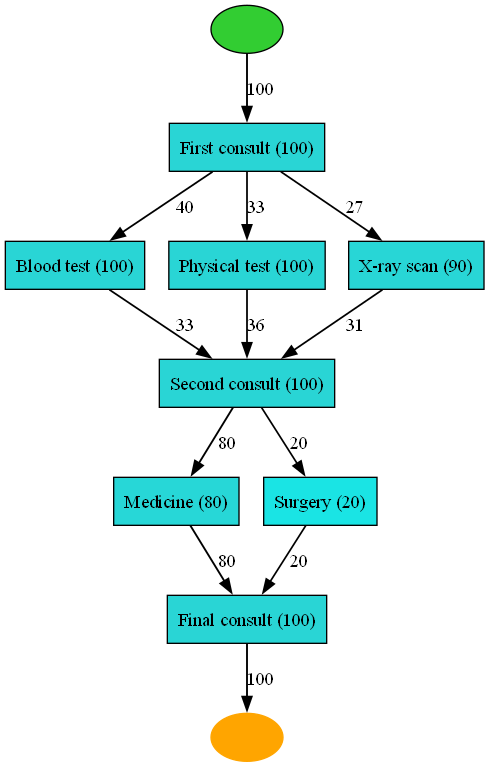
Betegutak és kórházi erőforrások: folyamatbányászat
Egy 100 beteg adatait tartalmazó kórházi eseménynaplóból rekonstruálom az ellátási utat, a lépések közötti időket és a személyzet terhelését. Az eszközök: közvetlen követési gráfok, Petri-hálók, BPMN és heurisztikus háló; az alfa-, induktív és heurisztikus algoritmusokat illeszkedés, pontosság, általánosítás és egyszerűség szerint hasonlítom össze.
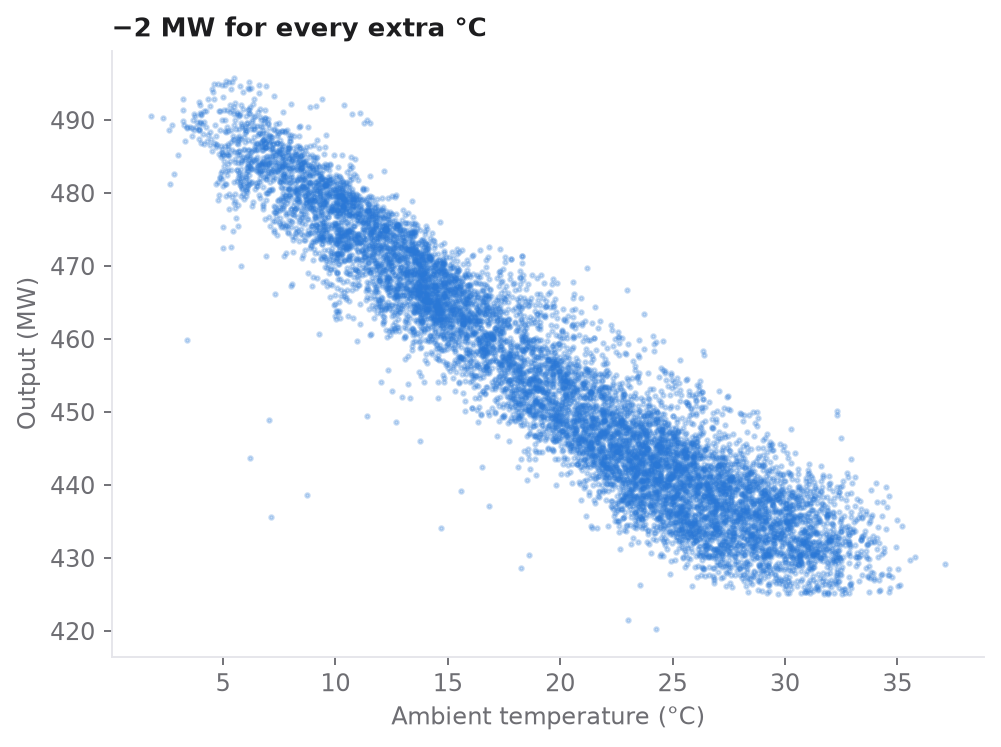
Erőművi teljesítmény becslése regressziós modellekkel
Mennyi villamos energiát termel egy kombinált ciklusú erőmű adott időjárási körülmények között? A feltáró elemzésből kiindulva lineáris, polinomiális, lasso-, ridge- és neurálisháló-modelleket hasonlítottam össze. Egy jól értelmezhető lineáris modellt választottam (R² = 0,93), amelyet keresztvalidációval és független mintán is ellenőriztem.
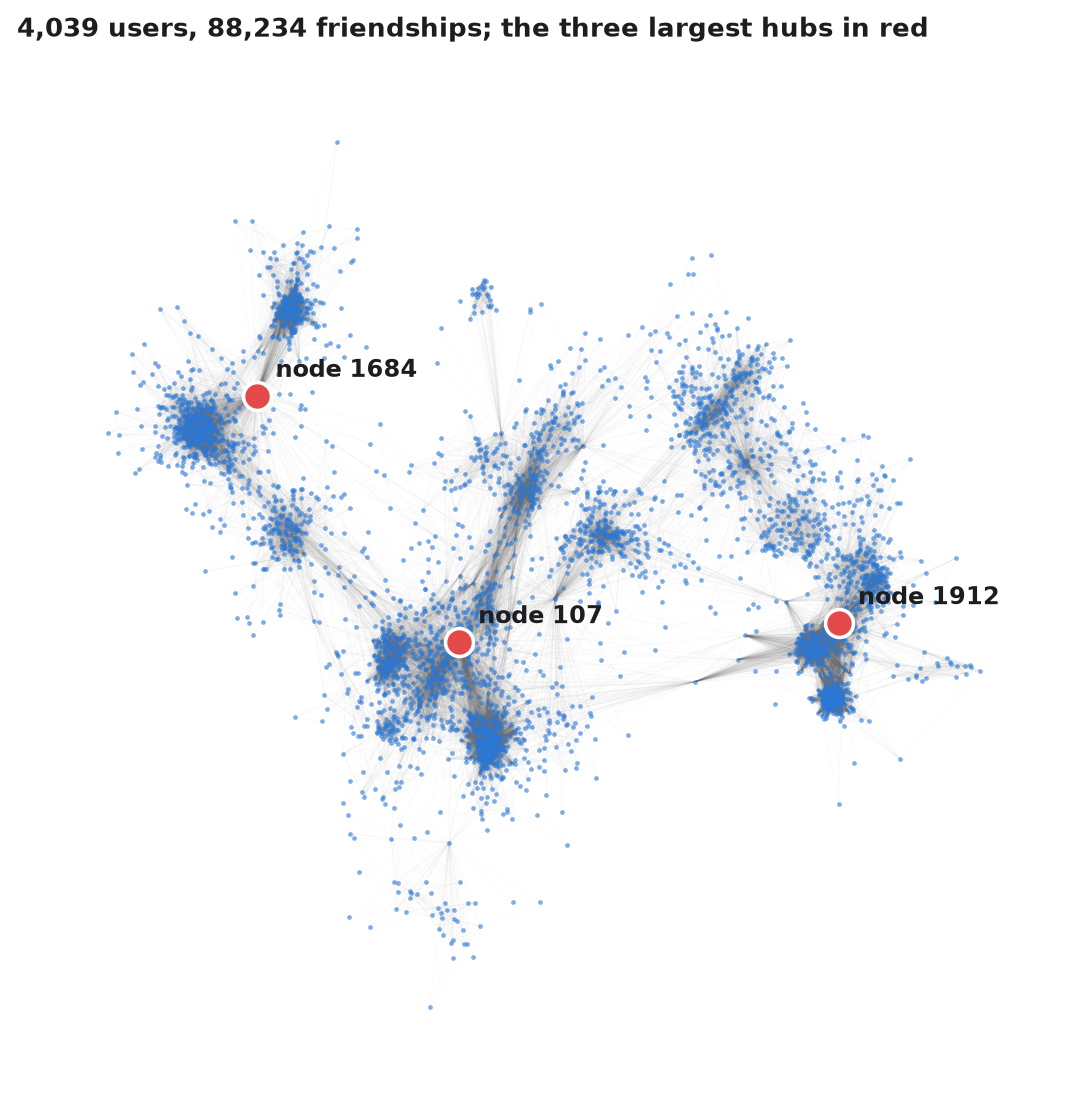
Hálózati struktúrák a szakirodalomban, a közösségi médiában és a szövegekben
A szentimentelemzés szakirodalmának térképe OpenAlex-adatokból, egy 4039 felhasználós, skálafüggetlen Facebook-ismeretségi háló három domináns csomóponttal, valamint politikai tweetek hasonlósági hálójának tematikus klaszterei.
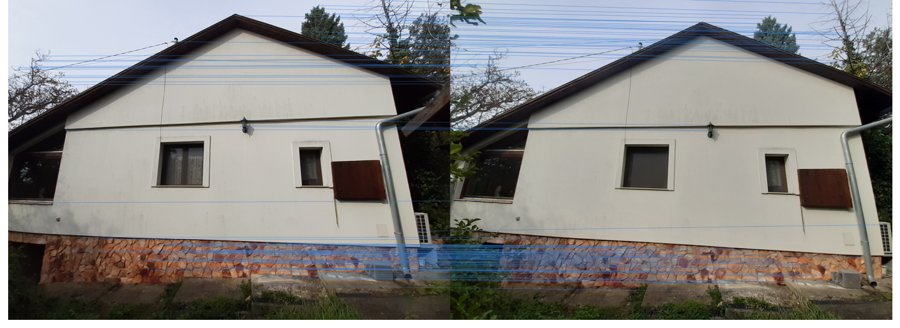
Egyező pontok keresése fényképek között SIFT-tel
Kulcspontok detektálása és párosítása két épületről, különböző szögből és fényképezőgéppel készült saját fotóimon. A mintázatos családi háznál több mint ezer megbízható egyezés adódik, a panelház ismétlődő homlokzatán jóval kevesebb.
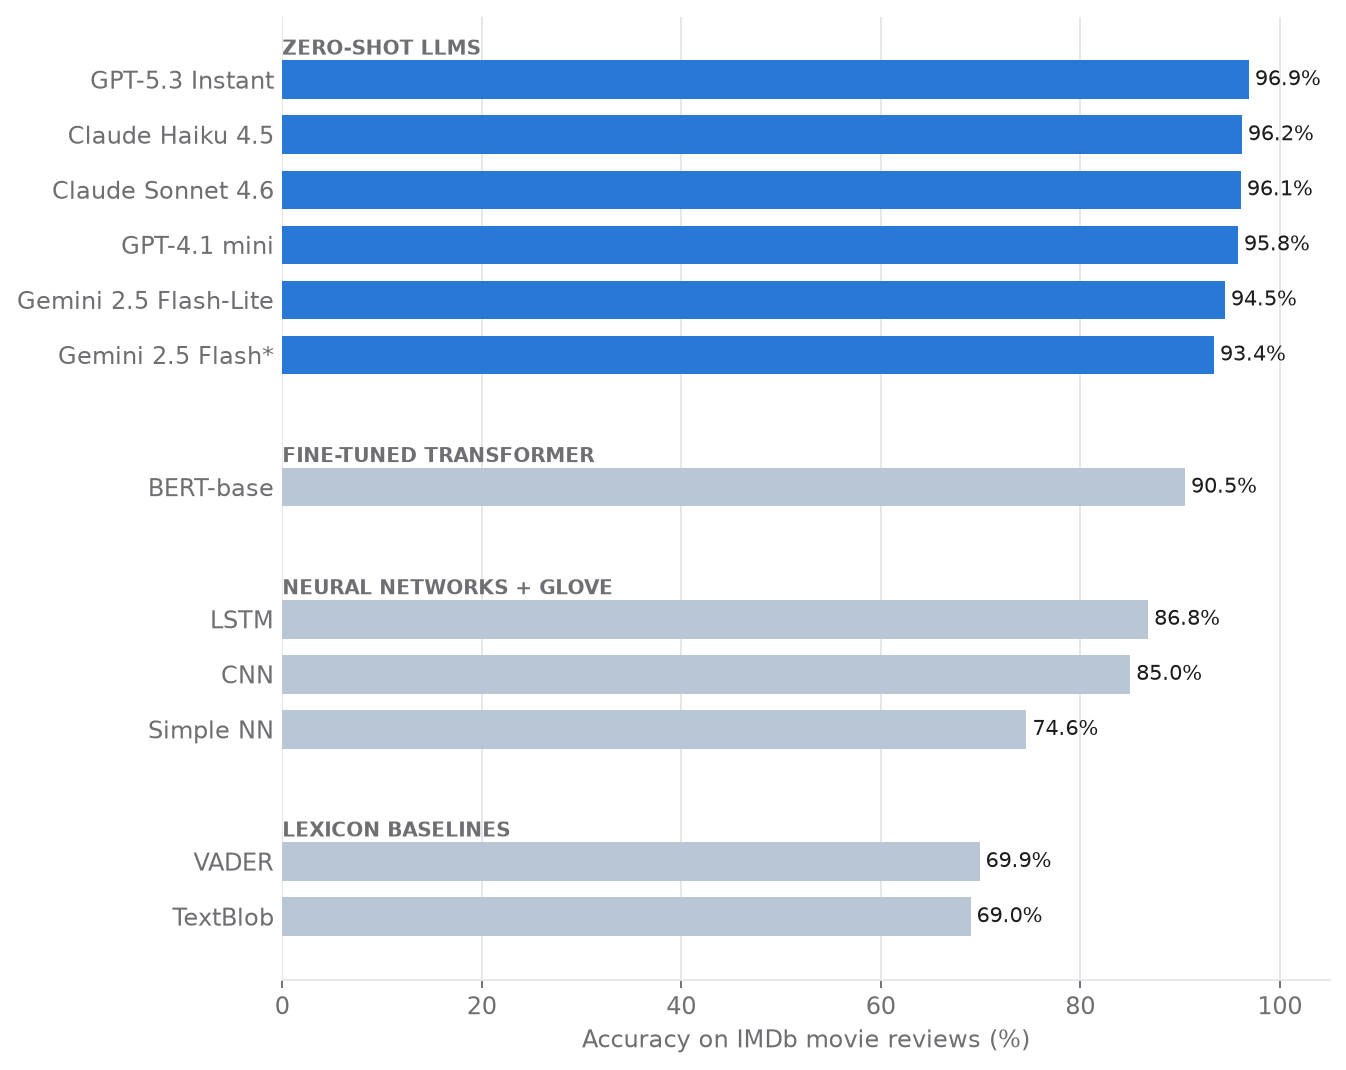
A szótáraktól a nagy nyelvi modellekig: szentiment-benchmark
Tizenkét megközelítés osztályozza ugyanazokat az IMDb-filmkritikákat: szótáralapú módszerek, neurális hálók, finomhangolt BERT, valamint tanítás nélküli (zero-shot) GPT-, Claude- és Gemini-modellek. A legjobb nyelvi modell tanítóadat nélkül 96,9%-os pontosságot ér el.
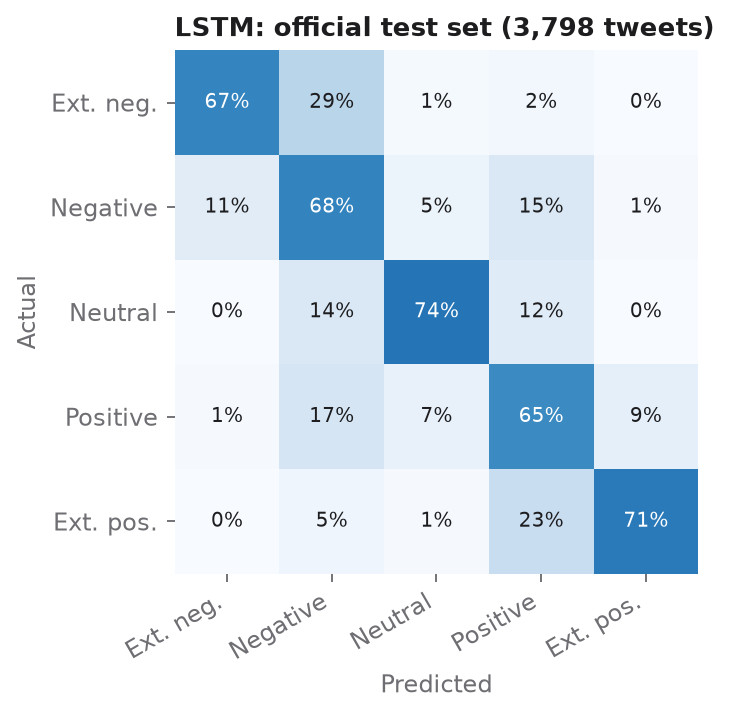
Szentimentelemzés háromféleképpen: neurális hálók és szótár
Egy kis, szóbeágyazásos (word embedding) neurális háló 85%-os pontossággal sorolja pozitív vagy negatív kategóriába az IMDb-filmkritikákat. Az öt hangulati fokozattal címkézett COVID-19-tweeteken a szavakat sorrendben feldolgozó LSTM jobb, mint az egyszerűbb sűrű háló (68,5% vs 65,1%). A tanítást nem igénylő VADER-szótár a légitársasági tweeteknek csak 54%-ánál egyezik az emberi címkékkel.
Amerikai légitársasági tweetek: hangulat-dashboard és szótárértékelés
Kétnyelvű Streamlit-dashboard hat amerikai légitársaságról szóló 14 640 címkézett tweetről, valamint a VADER szentimentszótár értékelése az emberi címkékhez mérve: 54%-os pontosság, a panaszok fele rejtve marad.
A COVID-19 sokk az amerikai munkaerőpiacon
R-alapú adatfeldolgozó folyamat, amely a Bureau of Labor Statistics API-jából tölti le a hivatalos statisztikákat, és ábrákon mutatja be, milyen mély volt a sokk és mennyi ideig tartott a kilábalás.